LLMOとは?AIに引用・推薦される仕組みと対策の手順をわかりやすく解説

LLMOとは?AIに引用・推薦される仕組みと対策の手順をわかりやすく解説

LLMO(Large Language Model Optimization/大規模言語モデル最適化)とは、ChatGPT・Gemini・Perplexity・Claudeなどの生成AIが質問に答えるときに、自社のサイトや会社名が正しく引用・推薦される状態をつくる取り組みです。中身の大部分はSEOと共通していますが、AIがどの経路で情報を集めるか、どのクローラーを通すかなど、LLMOならではの確認点もあります。

「LLMO」で検索すると、上位の記事は「対策○選」の形で施策を並べたものが中心で、AIの種類ごとに何が違うのか、どこから手を付ければよいのか、効果をどう確かめるのかは、ほとんど書かれていません。出典が示されていない記事も目立ちます。

本記事では、OpenAI・Perplexity・Anthropic・Googleの公式ドキュメントと、AISyncが自社で行っているAI検索の定点調査をもとに、次のことを整理します(2026年11月3日時点)。

  • LLMOの意味と、AIO・GEO・AEOとの関係
  • AIが情報を得る2つの経路と、LLMOで動かせる部分
  • AIごとのクローラーと、robots.txtで最初に確認すること
  • LLMO対策の4つの柱と、90日で回す手順
  • AI別の効果の測り方と、やらなくてよいこと

SEOとAIO(Google検索のAI機能向けの最適化)の違いや、Googleの公式見解の詳細は別記事で解説しているので、本記事はChatGPTやPerplexityを含む「生成AI全般での見え方」をどう整えるかに絞ります。

LLMOとは「生成AIの回答で、自社が正しく引用・推薦される状態をつくる」取り組み

LLMOのLLMは、ChatGPTやGeminiの土台になっている大規模言語モデル(Large Language Model)のことです。LLMOは、そのLLMを使ったAIが「おすすめのSEO会社は?」「リスティング広告の費用相場は?」といった質問に答えるときに、自社の情報が根拠として使われ、社名やページが回答の中に出てくるように整える取り組みを指します。

従来のSEOのゴールは検索結果で上位に表示されてクリックされることでした。LLMOでは、ユーザーがAIの回答を読んだ時点で、自社の名前・サービス・主張が正しく伝わっているかも成果として見ます。クリックされなくても、回答の中で比較候補に入れば、その後の指名検索や問い合わせにつながるためです。

似た言葉がいくつかありますが、指している範囲が少しずつ違うだけで、やることの土台は同じです。

用語 正式名称 主な対象 よく使われる場面
LLMO Large Language Model Optimization ChatGPT・Gemini・Claudeなど、LLMを使うAI全般 国内で「AIに推薦されたい」と言うとき
AIO AI Optimization GoogleのAIによる概要・AIモードなど Google検索のAI機能を意識するとき
GEO Generative Engine Optimization 生成AIを使った検索エンジン全般 英語圏の記事や研究論文
AEO Answer Engine Optimization 質問に直接答える回答エンジン 回答として抜き出されることを重視するとき

なお英語圏では、LLMOという言葉が「LLMそのものの処理速度や精度を上げる技術的な最適化」を指すこともあります。マーケティングの文脈で使われるLLMOは、本記事で扱う「AIの回答に向けたWebサイトや情報発信の最適化」の意味です。SEOとAIOの違いや用語の整理はSEOとAIOの違いとLLMOとの関係で詳しく解説しています。

AIが情報を得る経路は「学習データ」と「回答時の検索」の2つで、LLMOで動かせるのは主に後者

生成AIが回答に使う情報は、大きく2つの経路から来ています。この違いを押さえると、LLMOで何をすれば効果が出やすいかが分かります。

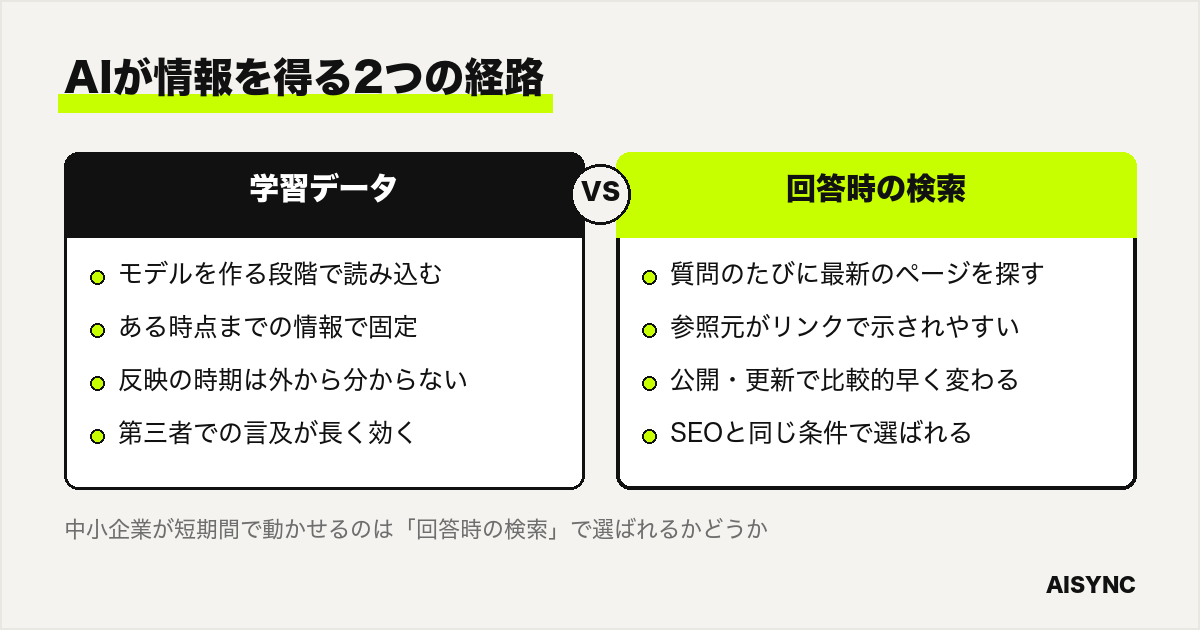
生成AIが情報を得る2つの経路(学習データと回答時の検索)の比較図
  1. 学習データ:モデルを作る段階で読み込まれた大量のテキストです。ある時点までの情報で固定されており、新しく書いた記事が反映されるのは次のモデルが作られるときで、いつ・どれだけ反映されるかは外から分かりません。
  2. 回答時の検索:ユーザーが質問したときに、AIがWeb検索や自社の検索インデックスで最新のページを探し、その内容を根拠に回答を作る仕組みです。参照したページはリンク付きで示されることが多く、記事を公開・更新すれば比較的早く結果が変わります。

ChatGPTの検索機能、Perplexity、GoogleのAIによる概要やAIモードは、いずれも回答時に検索した情報を使います。中小企業が短期間で変えられるのはこの「回答時の検索」で選ばれるかどうかで、ここはSEOと同じく検索インデックスに載っていること・質問への答えがページに書かれていること・信頼できる情報源だと判断されることで決まります。

一方、学習データへの反映は長い時間をかけて効いてくるものです。Web上で自社がどう語られているか(第三者のサイトでの言及や、表記のそろった会社情報)を積み重ねておくと、検索を使わずに答える場面でも社名が出やすくなります。LLMOでは、この2つを「すぐ効く対策」と「長く効く対策」として分けて考えると、優先順位を付けやすくなります。

AIごとにクローラーが違うので、まずrobots.txtで「検索用」を止めていないか確認する

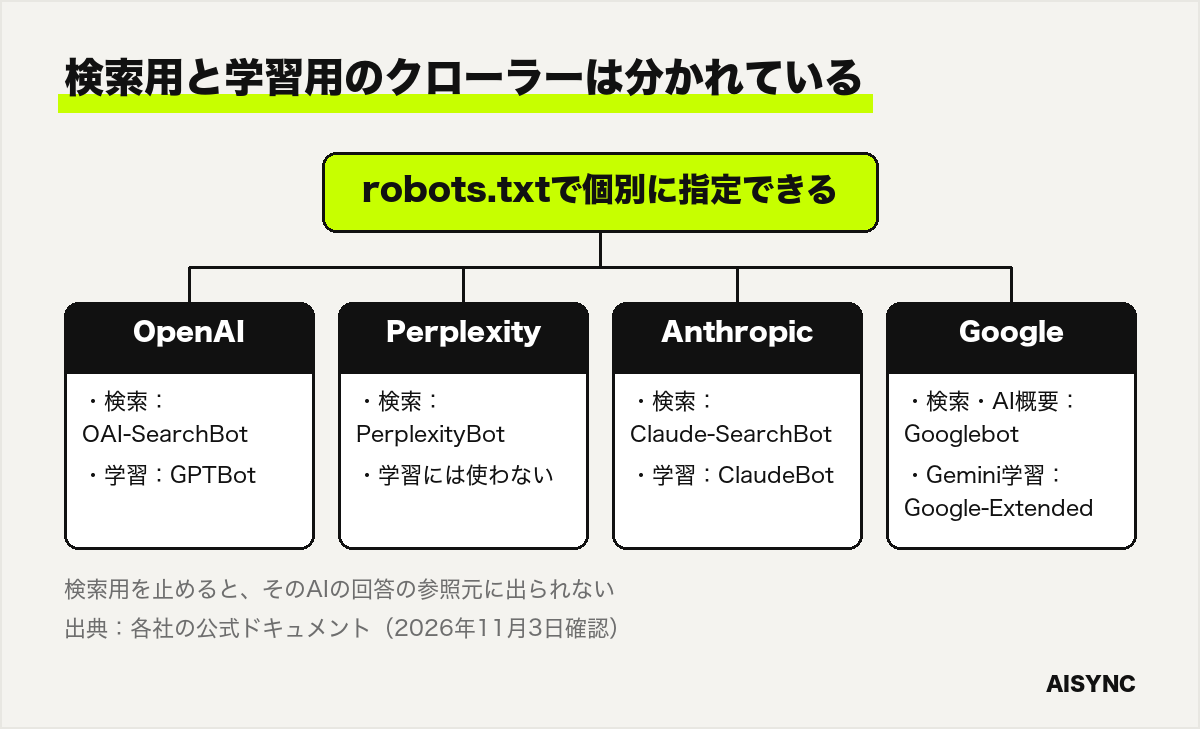
LLMOで最初に確認したいのが、AIの会社が使うクローラー(ページを読みに来るプログラム)を、自社サイトのrobots.txtで止めていないかです。主要なAIは、学習用のクローラーと、検索・回答用のクローラーを分けています。学習用だけを止めて、検索用は通すという設定もできます。

OpenAI・Perplexity・Anthropic・Googleの検索用と学習用のクローラー名の分類図
提供元 検索・回答の表示に使う モデルの学習に使う ユーザーの操作で読みに来る
OpenAI(ChatGPT) OAI-SearchBot(止めるとChatGPTの検索回答に表示されない) GPTBot ChatGPT-User(検索への表示可否には使われない)
Perplexity PerplexityBot(学習には使わないと明記) 公式の一覧に学習用の記載なし Perplexity-User(robots.txtは原則適用されない)
Anthropic(Claude) Claude-SearchBot ClaudeBot Claude-User
Google(Gemini・検索) Googlebot(AIによる概要・AIモードも通常の検索と同じ) Google-Extended(Geminiの学習とグラウンディングの可否を指定。Google検索への掲載や順位には影響しない) ―

たとえば、OpenAIのドキュメントには、OAI-SearchBotを拒否したサイトはChatGPTの検索回答に表示されないと書かれています。一方でGPTBotを拒否しても、それだけで検索回答から外れるとは書かれておらず、それぞれの設定は独立しています。「AIに学習されたくない」という理由でAI関連のクローラーをまとめて止めると、意図せず回答の参照元からも外れてしまうことがあるので注意が必要です。
参考:OpenAI「Overview of OpenAI Crawlers」/Perplexity「Perplexity Crawlers」/Anthropic「Does Anthropic crawl data from the web, and how can site owners block the crawler?」/Google検索セントラル「Googleの一般的なクローラ」

確認の手順は次のとおりです。

  1. ブラウザで「https://自社ドメイン/robots.txt」を開く
  2. 「User-agent: *」の下に「Disallow: /」がないか確認する(あるとすべてのクローラーを止めている)
  3. OAI-SearchBot・PerplexityBot・Claude-SearchBotなど、検索用のクローラー名を個別に「Disallow」していないか確認する
  4. 学習を断りたい場合は、GPTBot・ClaudeBot・Google-Extendedなど学習用の名前だけを指定する
  5. WAFやCDNのボット対策で、AIのクローラーをまとめて遮断する設定が入っていないか、サーバーの管理者に確認する

ここで止めていた場合は、どれだけ記事を良くしてもそのAIの回答には出られません。逆に言えば、LLMOの中でも数分で確認でき、影響が大きい項目です。

LLMO対策は「見つけてもらう・理解してもらう・選ばれる」の3段階を4つの柱で進める

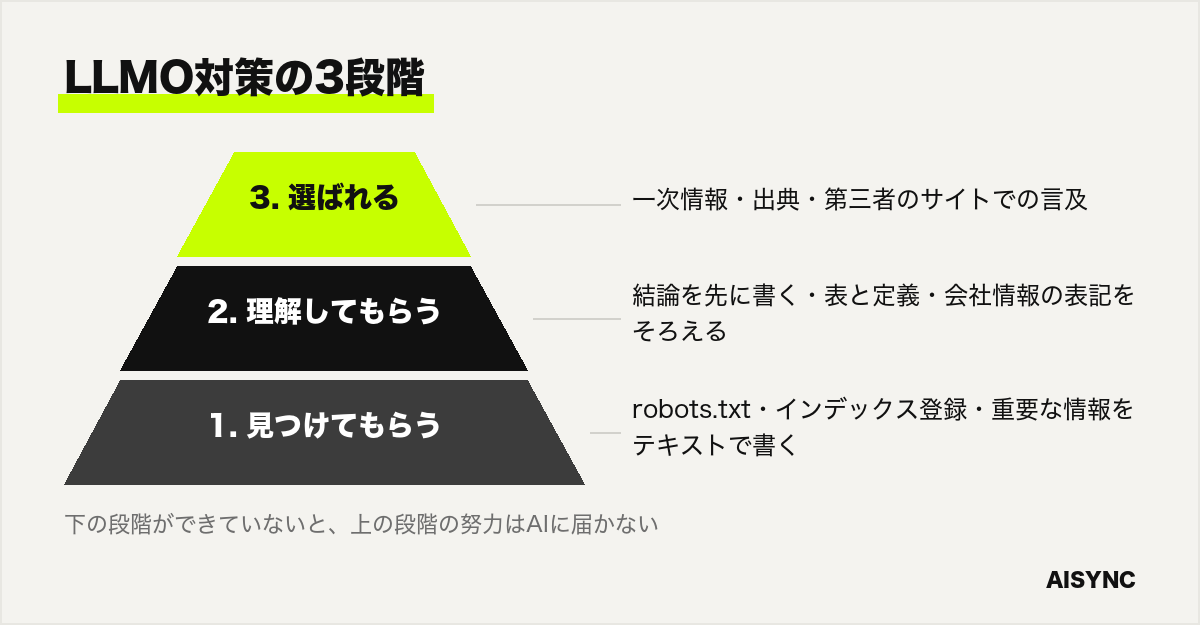
LLMOの施策は数が多く見えますが、AIの回答に自社が出るまでの段階で並べると、取り組む順番がはっきりします。

LLMO対策の3段階(見つけてもらう・理解してもらう・選ばれる)の階層図
段階 AIの側で起きること 主な対策
1. 見つけてもらう クローラーがページを読み、検索インデックスに載る robots.txt・インデックス登録・重要な情報をテキストで書く
2. 理解してもらう 質問に関係する箇所を正しく抜き出せる 結論を先に書く・表と定義・会社情報の表記をそろえる
3. 選ばれる 複数の情報源の中から根拠として採用される 一次情報・出典・第三者のサイトでの言及

1が満たされていないと2・3の努力は届きません。2と3は、Googleが「役に立つ、信頼できるコンテンツ」として求めている内容とほぼ重なります。ここからは、この3段階を実際の作業に落とした4つの柱を順に説明します。

対策1:AIが読める状態にする。重要な情報を画像やPDFだけに置かない

最初の柱は技術面の土台です。robots.txtの確認に加えて、次の点を見直します。

  • インデックス登録:GoogleのAIによる概要やAIモードに出るには、ページがインデックスに登録され、スニペット(検索結果の説明文)を表示できる状態であることが条件です。Search Consoleの「ページ」レポートで、主要なページが登録されているか確認します。
  • 重要な情報はテキストで書く:料金表や会社概要、サービスの対象範囲を画像やPDFだけで載せていると、AIが正しく読み取れないことがあります。画像を使う場合も、同じ内容を本文に文章や表で書きます。
  • 表示の制御を意図どおりにする:Google検索のAI機能に出したくない部分は、nosnippet・data-nosnippet・max-snippet・noindexなど、通常の検索と同じ指定で制御します。逆に、意図せずこれらの指定が入っていないかも確認します。
  • ページの表示速度とエラー:読み込みに失敗するページや、ログインしないと中身が見えないページは参照されません。

Googleは、AI機能に表示されるための特別な技術要件はなく、通常のSEOのベストプラクティスがそのまま当てはまると説明しています。AI専用の新しい設定を探すより、基本的な状態を点検するほうが先です。
参考:Google検索セントラル「AI機能とウェブサイト」

対策2:質問に直接答える文章と、根拠になる一次情報を置く

2つ目の柱は、ページの中身です。AIは質問に関係する部分をページから抜き出して回答を組み立てるので、質問への答えが短く明確に書かれていて、その根拠が示されているページほど使われやすくなります。

  • 見出しの直後に結論を書く:「初期費用は0円、月額は10万円から」「費用は作業の範囲で決まる」のように、見出しの最初の1〜2文で答えを言い切ります。
  • 比較や条件は表にする:料金プラン、対応範囲、向いている会社などは表にすると、AIが要素を取り出しやすくなります。
  • 数値には出典と時点を書く:「2026年11月時点」「Google 広告の公式ヘルプによると」のように、いつの・どこの情報かを明記します。
  • 自社にしかない情報を入れる:実際の運用データ、支援事例、現場での判断基準、失敗例などです。他のサイトと同じ一般論だけのページは、AIが別のサイトから同じ情報を取れるため、あえて選ぶ理由がありません。

この方向性は研究でも裏付けがあります。Aggarwal氏らの論文「GEO: Generative Engine Optimization」(KDD 2024採択)では、コンテンツに引用・統計・出典を加えるといった工夫で、生成エンジンの回答での見え方が最大40%向上したと報告されています。研究用に作った環境での結果なので、実際のAIで同じ数字が出るとは限りませんが、「根拠を示す」方向が有効だという目安にはなります。
参考:Aggarwal et al.「GEO: Generative Engine Optimization」(arXiv:2311.09735)

反対に、AI向けに文章を細かく区切ったり、特定の言い回しに書き換えたりする必要はありません。Googleは公式ガイドで、ページを細かく分割することもAI向けに書き直すことも不要だとしています。読者にとって分かりやすい構成にすることが、そのままAIにとっても読み取りやすい構成になります。
参考:Google検索セントラル「Google検索の生成AI機能向けにウェブサイトを最適化する」

対策3:会社名・サービス名・料金などの基本情報を、すべての媒体で同じ表記にそろえる

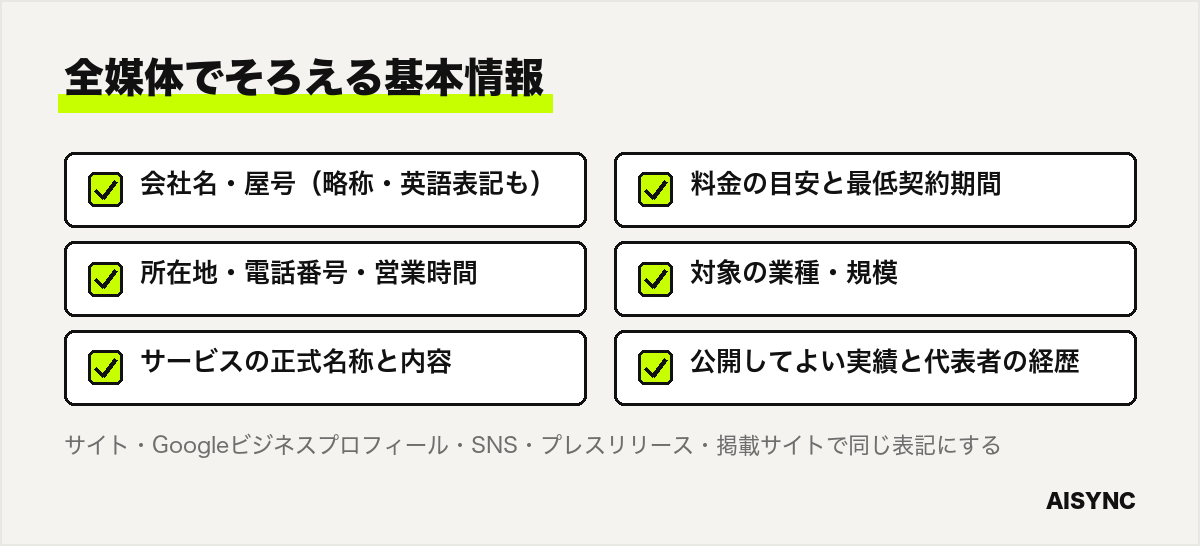
3つ目の柱は、自社がどんな会社かを示す基本情報(エンティティ情報)の一貫性です。AIは複数の情報源を照らし合わせて回答を作るため、サイトの会社概要、Googleビジネスプロフィール、SNSのプロフィール、プレスリリース、求人ページなどで表記がばらばらだと、別の会社として扱われたり、古い情報が回答に出たりする原因になります。

AIに正しく理解してもらうために全媒体でそろえる基本情報のチェックリスト

そろえておきたい項目は次のとおりです。

項目 そろえる内容 よくあるずれ
会社名・屋号 正式名称と略称、英語表記 「株式会社」の有無、全角・半角の違い
所在地・連絡先 住所、電話番号、営業時間 移転前の住所が古いページやSNSに残っている
サービス名と内容 サービスの正式名称と、何をするサービスか ページごとに呼び方が違う、終了したサービスが残っている
料金・対象 料金の目安、最低契約期間、対象の業種・規模 料金が「お問い合わせください」だけで、どこにも書かれていない
実績・代表者 公開してよい実績、代表者名と経歴 媒体ごとに実績の数字や肩書きが違う

特に料金と対象範囲は、AIに「おすすめの会社は?」と聞かれたときの比較材料になりやすい項目です。後述するAISyncの調査でも、推薦された会社には料金や契約条件を明記している会社が多く見られました。

対策4:比較記事やプレスリリースなど、第三者のサイトで言及される

4つ目の柱は、自社サイトの外での言及です。「おすすめのSEO会社は?」のような質問では、AIは個々の会社のサイトよりも、複数の会社を比較しているまとめ記事やランキング記事、ニュース、プレスリリースを参照元にすることが多くあります。自社サイトをどれだけ整えても、こうした第三者のページに名前が載っていなければ、推薦の候補に入りにくいのが実情です。

  • プレスリリース:新サービスや調査結果を出すときに配信し、事実に基づいた情報を第三者のサイトに残します。
  • 業界メディアへの寄稿・取材:専門分野の知見を、自社以外のメディアで発信します。
  • 比較サイト・掲載サービスへの登録:サービス比較サイトや発注先マッチングサイトに、正確な情報で掲載します。
  • 相互に価値のある紹介:テーマの近いメディアと、読者に役立つ範囲で記事を紹介し合います。

ただし、言及を増やす目的でリンクや口コミを購入したり、内容の薄いページを大量に作ったりするのは逆効果です。Googleのスパムポリシーでは、検索順位の操作を目的とした大量生成コンテンツやリンクの売買を明確に禁止しています。言及は「事実として紹介する価値がある情報」を出した結果として増やすものと考えます。
参考:Google検索セントラル「ウェブ検索のスパムに関するポリシー」

AISyncの現場では

AISyncでは、見込み客がAIにしそうな質問を10個決め、Perplexityで定点調査をしています。初回(2026年11月2日)の結果は、10問すべてでAISyncへの言及はありませんでした。自社のLLMOはまだスタート地点にあり、この記事もその改善の一環として書いています。

同じ調査で分かったのは、推薦される会社の出どころです。会社名が挙がった回答の多くは、比較まとめ記事が参照元になっていました。また、手数料・最低契約額・初期費用などの条件を明記している会社が回答の表に入りやすく、プレスリリース配信サイトが出典に含まれる質問もありました。「自社サイトの記事を増やす」だけでは推薦に届かず、料金と条件の明記と第三者のサイトでの言及が必要だというのが、私たちの現時点の判断です。

llms.txtは置いてもよいが、優先度は低い

LLMO対策として「llms.txt」の設置を勧める記事もあります。llms.txtは、Answer.AIのJeremy Howard氏が2024年9月3日に提案した仕組みで、サイトのルートなどにMarkdown形式のファイルを置き、AIのエージェントにサイトの概要と主要なページを伝えるものです。
参考:llmstxt.org「The /llms.txt file」

ただ、これはあくまで提案段階の仕組みで、主要なAIが回答の参照元を選ぶ基準として使っていると公式に示したものはありません。Googleは公式ガイドで、Google検索ではllms.txtを使っていないため作る必要はないとしています。置くこと自体に害はありませんが、robots.txtの確認や一次情報の追加より先にやる作業ではありません。

AISyncのサイトも、2026年11月3日時点でllms.txtは置いておらず、robots.txtではAIのクローラーを個別に止めていません。先に、記事の中身と会社情報の明記を進めています。

LLMOの効果は「AI別の計測ツール」と「定点質問」を組み合わせて測る

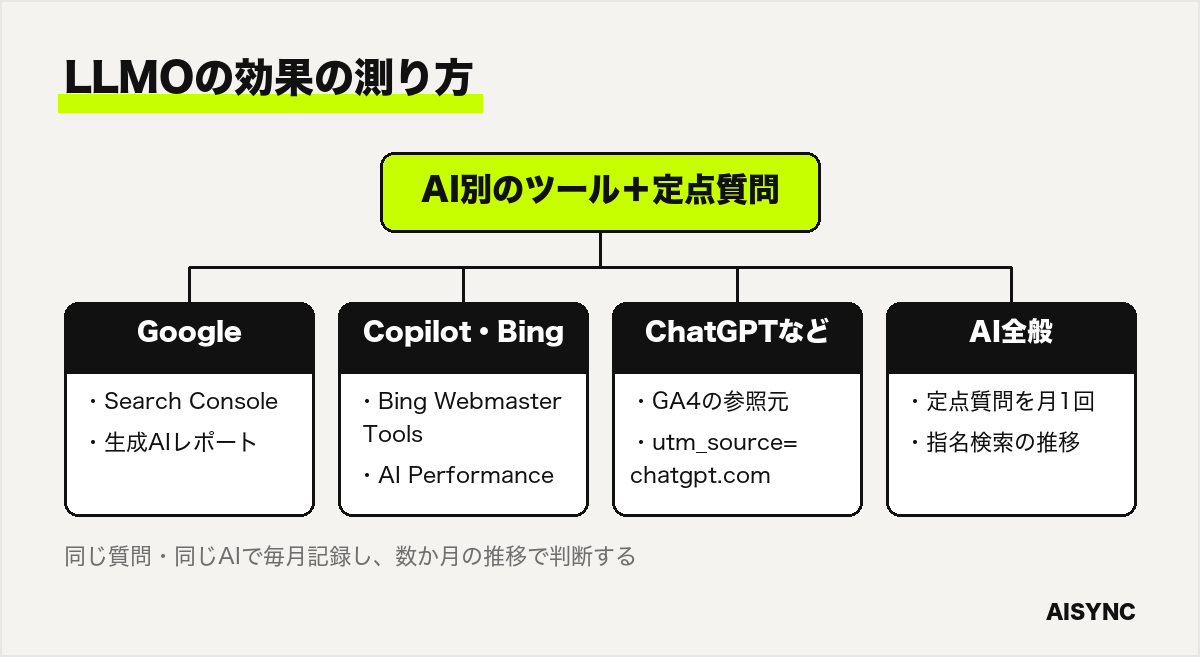
LLMOは効果が測りにくいと言われてきましたが、2026年には計測の手段が増えています。ただしAIごとに見られる数字が違うので、組み合わせて使います。

LLMOの効果をAI別の計測ツールと定点質問で測る方法の分類図
見たいこと ツール・方法 分かること
Google検索のAI機能での表示 Search Consoleの生成AIパフォーマンスレポート AIによる概要・AIモードなどでの表示回数と、表示されたページ
CopilotとBingのAI要約での引用 Bing Webmaster ToolsのAI Performance(2026年2月10日に公開プレビュー) 引用された回数、引用されたページ、AIが検索に使ったフレーズ(グラウンディングクエリ)
ChatGPTなどからの訪問 GA4の参照元(chatgpt.com、perplexity.aiなど) AI経由の訪問数と、その後の問い合わせ。ChatGPTの検索からのリンクには utm_source=chatgpt.com が付く
回答の中での言及 主要なAIへの定点質問(手動で記録) 社名が出るか、どのページが参照元か、競合はどこか
認知の変化 Search Consoleの指名キーワード 社名・サービス名での検索数の推移

定点質問は、毎月同じ質問・同じAIで記録することが大切です。AIの回答は聞くたびに少しずつ変わるので、1回の結果で一喜一憂せず、数か月の推移で見ます。GoogleのSearch Consoleの使い方はSEOとAIOの違いの記事で、計測ツールの費用はSEOツールの比較記事で詳しく解説しています。
参考:Bing Webmaster Blog「Introducing AI Performance in Bing Webmaster Tools Public Preview」/OpenAI「Publishers and Developers – FAQ」

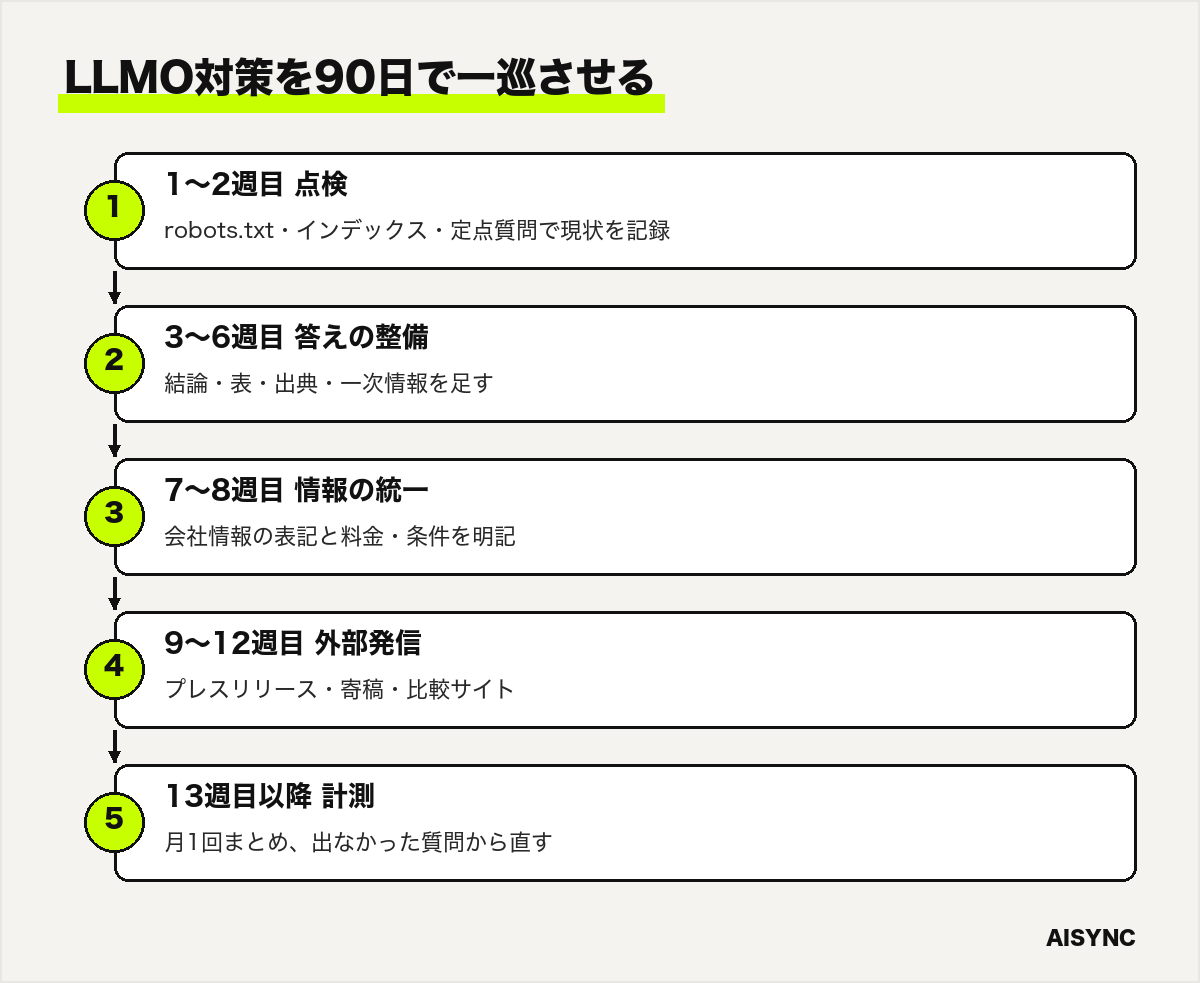
LLMO対策は90日で「点検→答えの整備→情報の統一→外部発信→計測」を回す

ここまでの4つの柱を、中小企業が無理なく進められる順番に並べると次のようになります。最初の90日で一巡させ、その後は毎月の計測をもとに改善を続けます。

LLMO対策を90日で回す5つの手順の流れ図
  1. 1〜2週目:点検。robots.txtとボット対策の設定、主要ページのインデックス登録、料金や会社概要が画像だけになっていないかを確認します。あわせて、見込み客がAIにしそうな質問を5〜10個決め、ChatGPT・Gemini・Perplexity・GoogleのAIモードで現状を記録します。
  2. 3〜6週目:答えの整備。定点質問に答えるページがあるかを確認し、なければ作る、あれば見出し直後の結論・表・出典・一次情報を足します。まずは問い合わせに近いサービスページと費用・選び方の記事からです。
  3. 7〜8週目:情報の統一。会社概要、Googleビジネスプロフィール、SNS、掲載サイトの表記をそろえ、料金の目安・対象・契約条件をサイトに明記します。
  4. 9〜12週目:外部発信。プレスリリース、業界メディアへの寄稿、比較サイトへの正確な掲載など、第三者のサイトに事実を残す取り組みを始めます。
  5. 13週目以降:計測と改善。Search Console・Bing Webmaster Tools・GA4・定点質問の結果を月1回まとめ、言及されなかった質問に対応するページを優先して直します。

この順番にしているのは、前の段階ができていないと後の段階の効果が出ないからです。クローラーを止めたまま記事を増やしても、会社情報がばらばらのまま外部発信を増やしても、AIの回答には正しく反映されません。

LLMOで「やらなくてよいこと」と注意点は4つ

LLMOは新しい分野なので、根拠の薄い施策も多く出回っています。次の4つは、優先度を下げるか、避けたほうがよいものです。

  • AI向けのページを大量に作る:質問ごとに似たページを量産するのは、Googleのスパムポリシーの「大量生成コンテンツの不正使用」に当たるおそれがあります。1ページを深く、正確にするほうが効果的です。
  • AIの言い回しに合わせた書き換え:AIは類義語や意図を理解できるため、特定のフレーズを詰め込む必要はありません。読みにくくなるだけです。
  • 「必ずAIに推薦される」とうたうサービスへの依頼:AIの回答は各社のシステムが決めるもので、外部の会社が表示を保証することはできません。保証をうたう提案は、施策の中身と計測方法を確認してから判断します。
  • SEOをやめてLLMOだけに切り替える:回答時の検索は検索インデックスと評価の仕組みに支えられているため、SEOの土台を崩すとLLMOの効果も落ちます。

また、AIの回答に自社について誤った情報が出ることもあります。その場合は、誤りの元になっているページ(古い会社情報、終了したサービスのページ、第三者の古い記事など)を探し、自社で直せるものは更新し、第三者のページは掲載元に修正を依頼します。

自社で進める範囲と外注する範囲は「社内の情報を持っているか」で分ける

LLMO対策は、すべてを外注する必要はありません。自社にしかない情報が関わる作業は社内で、専門知識や手間がかかる作業は外部に頼むという分け方が現実的です。

作業 自社で進めやすい 外注を検討したい
robots.txtと技術の点検 robots.txtを開いて確認する程度 WAF・CDNの設定、インデックスの問題の調査
定点質問の設計と記録 質問の候補出し、毎月の記録 競合を含めた分析、AIごとの差の読み解き
ページの改善 料金・会社情報・事例など事実の提供 構成の設計、検索意図の調査、執筆・リライト
基本情報の統一 各媒体のプロフィールの修正 表記ルールの設計、構造化データの実装
外部発信 発信するネタ(調査・新サービス)の判断 プレスリリースの作成、メディアへの提案

外注する場合の費用の目安はAIO対策・LLMO対策の費用相場で、依頼先の比べ方はAIO対策の会社の選び方で解説しています。AISyncのSEO・AIO対策の支援では、SEOの土台づくりとAI検索での見え方の計測を一体で進めています。

LLMOに関するよくある質問

LLMOは意味がない、怪しいという声もありますが本当ですか?

「LLMO専用の裏技」のような施策には根拠の薄いものもありますが、AIの回答に正しく出るための取り組み自体には意味があります。ChatGPTやPerplexityは回答時に検索したページを参照元として示しており、クローラーを止めていれば表示されないことは各社の公式ドキュメントに書かれています。根拠のある基本から進め、効果は定点質問と計測ツールで確かめるのが確実です。

LLMOとLLMOpsは同じものですか?

違います。LLMOpsは、企業がLLMを使ったシステムを開発・運用・監視するための仕組みや手法のことで、エンジニアリングの用語です。マーケティングで使うLLMOは、AIの回答で自社が正しく扱われるための情報発信の最適化を指します。

LLMO対策はいつから始めるべきですか?

robots.txtの確認と定点質問の記録は、今日から始めて問題ありません。数分から数時間でできる作業で、現状が分からないまま施策を選ぶよりも判断が正確になります。ページの改善や外部発信は、SEOの施策と同じ計画の中に組み込んで進めます。

LLMO対策は自社だけでできますか?

点検、定点質問の記録、会社情報の統一、料金や事例の明記は、自社だけでも進められます。検索意図に合わせた記事の設計や、技術的な問題の調査、プレスリリースの作成など、専門知識や工数が必要な部分だけを外部に頼む形でも十分に効果を狙えます。

LLMOのためにSEOをやめてもよいですか?

おすすめしません。ChatGPTの検索機能やGoogleのAIによる概要は、検索インデックスにあるページを参照して回答を作ります。SEOで検索インデックスに載り、信頼できるページとして評価されていることが、LLMOの前提になります。SEOの土台の上に、AI別の確認と外部での言及を足すと考えてください。

まとめ|LLMOは「AIに見つけてもらい、理解され、選ばれる」状態をSEOの土台の上につくること

LLMOは、生成AIの回答で自社が正しく引用・推薦される状態をつくる取り組みです。AIが情報を得る経路のうち、すぐに変えられるのは回答時の検索で、そこで選ばれるかどうかはSEOと同じく、インデックス・質問への明確な答え・信頼できる根拠で決まります。

まずはrobots.txtで検索用のクローラーを止めていないかを確かめ、見込み客がAIにしそうな質問で現状を記録してください。そのうえで、答えのページの整備、会社情報と料金の明記、第三者のサイトでの言及の順に進め、Search Console・Bing Webmaster Tools・GA4・定点質問で毎月の変化を確認すれば、LLMOは「よく分からない新施策」ではなく、測りながら改善できる施策になります。

AI検索で自社がどう見えているかを確かめ、SEOとあわせて改善したい方へ

AISyncでは、SEO・AIO対策の支援として、robots.txtや主要ページの点検、見込み客の質問を使ったAI検索の定点調査、検索とAIの両方で選ばれるページへの改善を一貫して行っています。「AIに聞いても自社が出てこない」という段階からご相談いただけます。

AISyncに相談する